1. SVN 서버로부터 소스 및 이력을 GIT 형태로 가져 오기
cd orggit
git svn clone svn://softgear@SVNSERVERIP:PORT/trunk/project
2. 받은 디렉토리를 통째로 다른 서버(git전용)로 복사, 읽기쓰기 권한 부여
scp -r -P SSHPORT project softgear@GITSERVER:/opt/git/project
3. GIT 서버의 리파지토리를 bare 로 변경
http://stackoverflow.com/questions/2199897/how-to-convert-a-normal-git-repository-to-a-bare-one
cd /opt/git/project
mv .git .. && rm -fr *
mv ../.git .
mv .git/* .
rmdir .git
git config --bool core.bare true
cd ..; mv project project.git # renaming just for clarity
4. 다른 PC에서 GIT 서버로부터 clone 받고 작업후 push.
5. SVN 서버에서 GIT 서버로부터 clone 받음
cd newgit
git clone ssh://softgear@GITSERVER:PORT/opt/git/project.git
6. remote SVN 정보를 복사 (처음 받았던 git 리파지터리 orggit 로부터)
cd .git
cp -r orggit/.git/svn .
cp orggit/.git/refs/remotes/git-svn
vi config ( orggit/.git/config 의 [svn-remove "svn"] 섹션을 붙인다.
7. GIT에서 변경된 내용을 SVN에 다시 반영
git svn dcommit
8. SVN에서 변경된 내용을 GIT로 반영
git svn rebase
2015년 1월 4일 일요일

2014년 11월 4일 화요일
CoAP Group Comm. 드래프트, RFC7390 으로 채택
며칠전 (2014년 10월31일)에 CoAP Group Comm. 드래프트가 RFC7390 으로 채택되었습니다. http://tools.ietf.org/html/rfc7390
대충 봤는데요. 참고하시기 바랍니다.
IP multicast를 써서 일괄적으로 GET을 하거나 PUT을 하는 것에 대한 내용입니다.
요청은 멀티캐스트로 전송하고, 응답은 unicast로 각자 전송하며, 모든 coap server가 동시에 응답하는 충돌 방지를 위해 간단한 congestion
control (랜덤한 시간후에 전송, 가능한 작은 메시지 응답) 기법이 제시되어 있습니다.
IGMP,MLD를 쓰지 않고 COAP을
써서 멤버쉽 관리하는 것을 포함하고 있네요.
그밖에 여러가지망에 대한 고려사항, 네이밍, Usecase 등이 포함되어 있습니다.
보안에 대해서는 아직 미지원입니다.(No Security mode)
대표적인 예제 플로우로, 일괄로 (거의
동시에) 전등을 켜는 시나리오입니다.
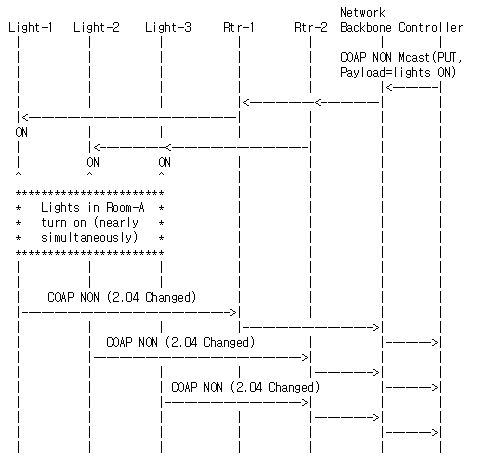
Figure 5: Controller on Backbone Sends
Multicast Control Message
2014년 11월 3일 월요일
Java 에서 exec 로 외부 프로그램 띄우고 입출력처리 중요
Java Runtime.exec로 외부 프로그램을 띄운뒤,
외부프로그램의 standard output 처리를 안해주면, 출력버퍼가 다 차면 동작이 fflush() 나 write() 함수에서 blocking되어 멈춰버린다.
2014년 4월 16일 수요일
프로세스 관점의 데이터마이닝, 수행단계
프로세스 관점의 데이터 마이닝

데이터마이닝의 수행단계
1. 데이터마이닝 프로젝트의 목적 확인
2. 분석에서 사용될 데이터 획득 : 대량의 데이터베이스에서 무작위로 표본 추출, 데이터베이스에서 데이터를 합치기 등
3. 데이터를 탐색, 정제, 전처리 : 데이터의 범위, 그래프 통한 확인, 데이터의 일관성 확인
4. 데이터 축소, supervised 의 경우 데이터를 학습용(training) 데이터, 평가용(test) 데이터, 검증용(validation) 데이터으로 분할 : 불필요 변수 제거, 변수를 변환, 새로운 변수 생성
5. 데이터마이닝 분석유형 선택 : 분류, 예측, 군집 중 어떤 것으로 할 것인가 결정
6. 데이터마이닝 기법 선택 : 회귀분석, 신경망모델, 계층적 군집분석 중 어떤 기법을 쓸 것인지 결정
7. 알고리즘 적용, 데이터마이닝 작업 수행 : 알고리즘 내 변수, 세부 선택 조건 등 다양한 변인들을 적용. 평가용 데이터를 이용하여 피드백
8. 알고리즘 결과 해석 : 검증용 데이터를 이용 최종 선택한 알고리즘을 평가
9. 모형 활용 : 모형을 운영시스템과 통합, 실제 레코드들을 적용하여 운영
("비즈니스 인텔리전스를 위한 데이터 마이닝"에서)
데이터 유형에 따른 데이터마이닝 기법의 분류
데이터 유형에 따른 데이터마이닝 기법의 분류
("비즈니스 인텔리전스를 위한 데이터 마이닝"에서)
| 연속형 반응변수(Continuous Response Variable) | 범주형 반응변수(Categorical Response Variable) | 반응변수가 없는 경우(unsupervised) | |
| 연속형 예측변수(Continuous Predictor) | 선형 회귀분석(Linear regression) 신경망 모형(Neural Network Model,NN) k-최근접이웃기법(k-nearest neighbor,K-NN) |
로지스틱 회귀분석(Logistic regression) 판별분석(discriminant analysis) k-최근접이웃기법(k-nearest neighbor,K-NN) |
주성분 분석(Principal Component Analysis,PCA) 군집분석(Cluster Analysis) |
| 범주형 예측변수(Categorical Predictor) | 선형 회귀분석(Linear regression) 신경망 모형(Neural Network Model,NN) 회귀나무(Regression Tree) |
신경망모형(Neural Network Model,NN) 분류나무(classification tree) 로지스틱 회귀분석(Logistic regression) 단순 베이즈 분류모형(Naive Bayesian Classification) |
연관성규칙(Association rules) |
("비즈니스 인텔리전스를 위한 데이터 마이닝"에서)
데이터 마이닝 기법이 다양한 이유, 기법 선택시 고려사항
데이터 마이닝에 사용되는 예측 및 분류를 위한 다양한 방법이 존재.
각 기법이 나름대로 장단점을 가지기 때문.
어느 한 기법의 유용성 즉 기법 선택시 고려사항은 다음 것들이 있다.
각 기법이 나름대로 장단점을 가지기 때문.
어느 한 기법의 유용성 즉 기법 선택시 고려사항은 다음 것들이 있다.
- 데이터 집합의 크기
- 데이터에 존재하는 패턴의 유형
- 해당 기법이 요구하는 가정을 데이터가 만족시키는지 여부
- 데이터 잡음의 정도
- 특수한 분석 목적 등
일반적으로 통용되는 방식은 여러가지 다양한 데이터마이닝 기법들을 적용해보고, 그 목적중에 가장 유용한 기법을 선택하는 것.
("비즈니스 인텔리전스를 위한 데이터 마이닝"에서)
("비즈니스 인텔리전스를 위한 데이터 마이닝"에서)
2014년 4월 15일 화요일
Machine Learning : 모델 선택 방법. 3. Bayesian statistics and regularization
이 글에서는 overfitting 에 대응하는 또하나의 툴에 대해 다룬다.
maximum likelihood (ML)을 이용하여 parameter fitting 하는 방법이 있다. 그리고 parameter는 다음에 따라 선택한다.


 (1)
위 식에서, p(y^(i),x^(i),theta) 는 사용하는 러닝 모델로 부터 나온다. 예를 들어, Bayesian logistic regression을 사용한다면, p(y^(i),x^(i),theta) 는 다음과 같이 될 것이다.

여기서 새로운 테스트 예제 x가 주어지고, 그것을 예측하여야 한다면, theta에 대한 posterior distribution을 사용하여 class label에 대한 posterior distribution를 다음과 같이 계산할 수 있다.
 (2)

 (3)

maximum likelihood (ML)을 이용하여 parameter fitting 하는 방법이 있다. 그리고 parameter는 다음에 따라 선택한다.
여기서 theta 는 constant-valued but unknown 으로 frequentist statistics내에서 취해진다. 이 파라메터를 유추하기 위해 maximum likelihood와 같은 통계적 절차(statistics procedure)를 따르는 것이 우리의 할 일이다.
parameter 유추 문제에 접근하는 또다른 방법은, Bayesian view를 갖는 것이다. 그리고 theta를 random variable로 생각하는 것이다. 이 방법에서, 파라메터에 대한 "prior beliefs" (미리 이럴 것이다라고 유추하는 것)을 적용하여, 확률분포 prior distribution p(theta)를 사용한다. training set S
가 주어지고, x의 새로운 값을 예측하려고 하면, 다음과 같은 posterior distribution 를 계산할 수 있다.
(1) (2)
위 식에서 p(theta|S) 는 수식(1) 로부터 얻는다. 따라서 x가 주어질때 y 값을 예측하는 경우, 다음과 같은 결과를 얻을 수 있다.
이러한 과정을, "fully Bayesian" prediction 을 수행하는 것으로 생각할 수 있다. 그것은 theta에 대한 posterior p(theta|S) 를 반영하는 평균치를 취하여 계산하는 것을 말한다. 그런데, 일반적으로, 이 posterior distribution 을 계산하는 것은 계산상으로 무척 어렵다. 왜냐하면, 수식(1)의 theta는 보통 매우 높은 차원이고 이것에 대해 적분(integral)을 해야 하기 때문이다. 게다가 이것은 보통 closed-form으로 되지 않을 수 있다.
그래서, 실제적으로는, theta에 대한 posterior distribution을 approximate 한다. 하나의 예로, 수식(2)와 같은 posterior distribution를 single point estimate 로 대치하는 것이다. MAP (maximum a posterior) estimate는 다음과 같다.
(3)
이것은 theta에 대한 ML(maximum likelihood) estimate를 위한 공식과 같다. 단지 끝에 prior p(theta) 가 있는 것을 제외하고 말이다.
실제적인 응용에서, prior p(theta) 에 대한 일반적인 선택은, 다음을 가정하는 것이다.
이러한 prior 선택을 사용하여, fitted parameters theta_MAP 은 maximum likelihood에 의해 선택된 것보다 더 작은 norm 을 갖는다. 실제로, Bayesian MAP estimate 가 ML estimate보다 overfitting에 대해 덜 취약(susceptible)하게 된다. 예를 들어, Bayesian logistic regression 은, n>>m 인 경우에도 text classification에 효과적인 알고리즘으로 밝혀졌다.
(참조 Andrew Ng 강의노트)
피드 구독하기:
글 (Atom)